
Отчет по лабораторной работе #5 выполнил(а):
- Оглоблин Глеб Александрович
- РИ210941 Отметка о выполнении заданий (заполняется студентом):
| Задание | Выполнение | Баллы |
|---|---|---|
| Задание 1 | * | 80 |
| Задание 2 | * | 20 |
знак "*" - задание выполнено; знак "#" - задание не выполнено;
Работу проверили:
- к.т.н., доцент Денисов Д.В.
- к.э.н., доцент Панов М.А.
- ст. преп., Фадеев В.О.
Структура отчета
- Данные о работе: название работы, фио, группа, выполненные задания.
- Цель работы.
- Задание 1.
- Код реализации выполнения задания. Визуализация результатов выполнения (если применимо).
- Задание 2.
- Код реализации выполнения задания. Визуализация результатов выполнения (если применимо).
- Задание 3.
- Код реализации выполнения задания. Визуализация результатов выполнения (если применимо).
- Выводы.
-Интеграция экономической системы в проект Unity и обучение ML-Agen
- Открыл проект Unity и добавил в него ML-Agent, запустил, шар двигвется от одного куба к другому
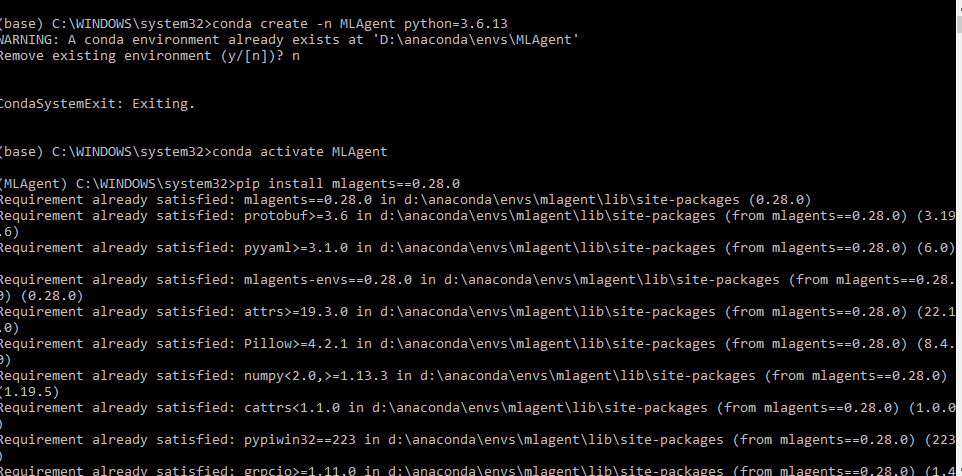
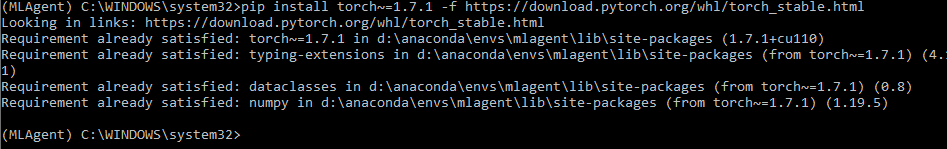
- Подготавливаю к работе ML Agent
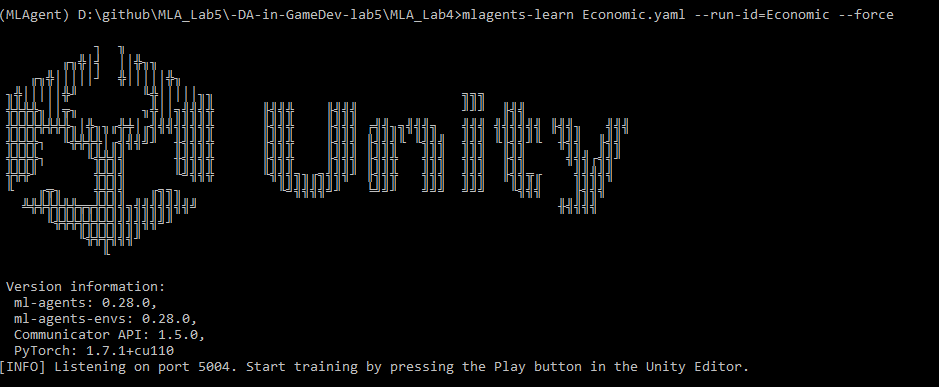
- Запускаю проект
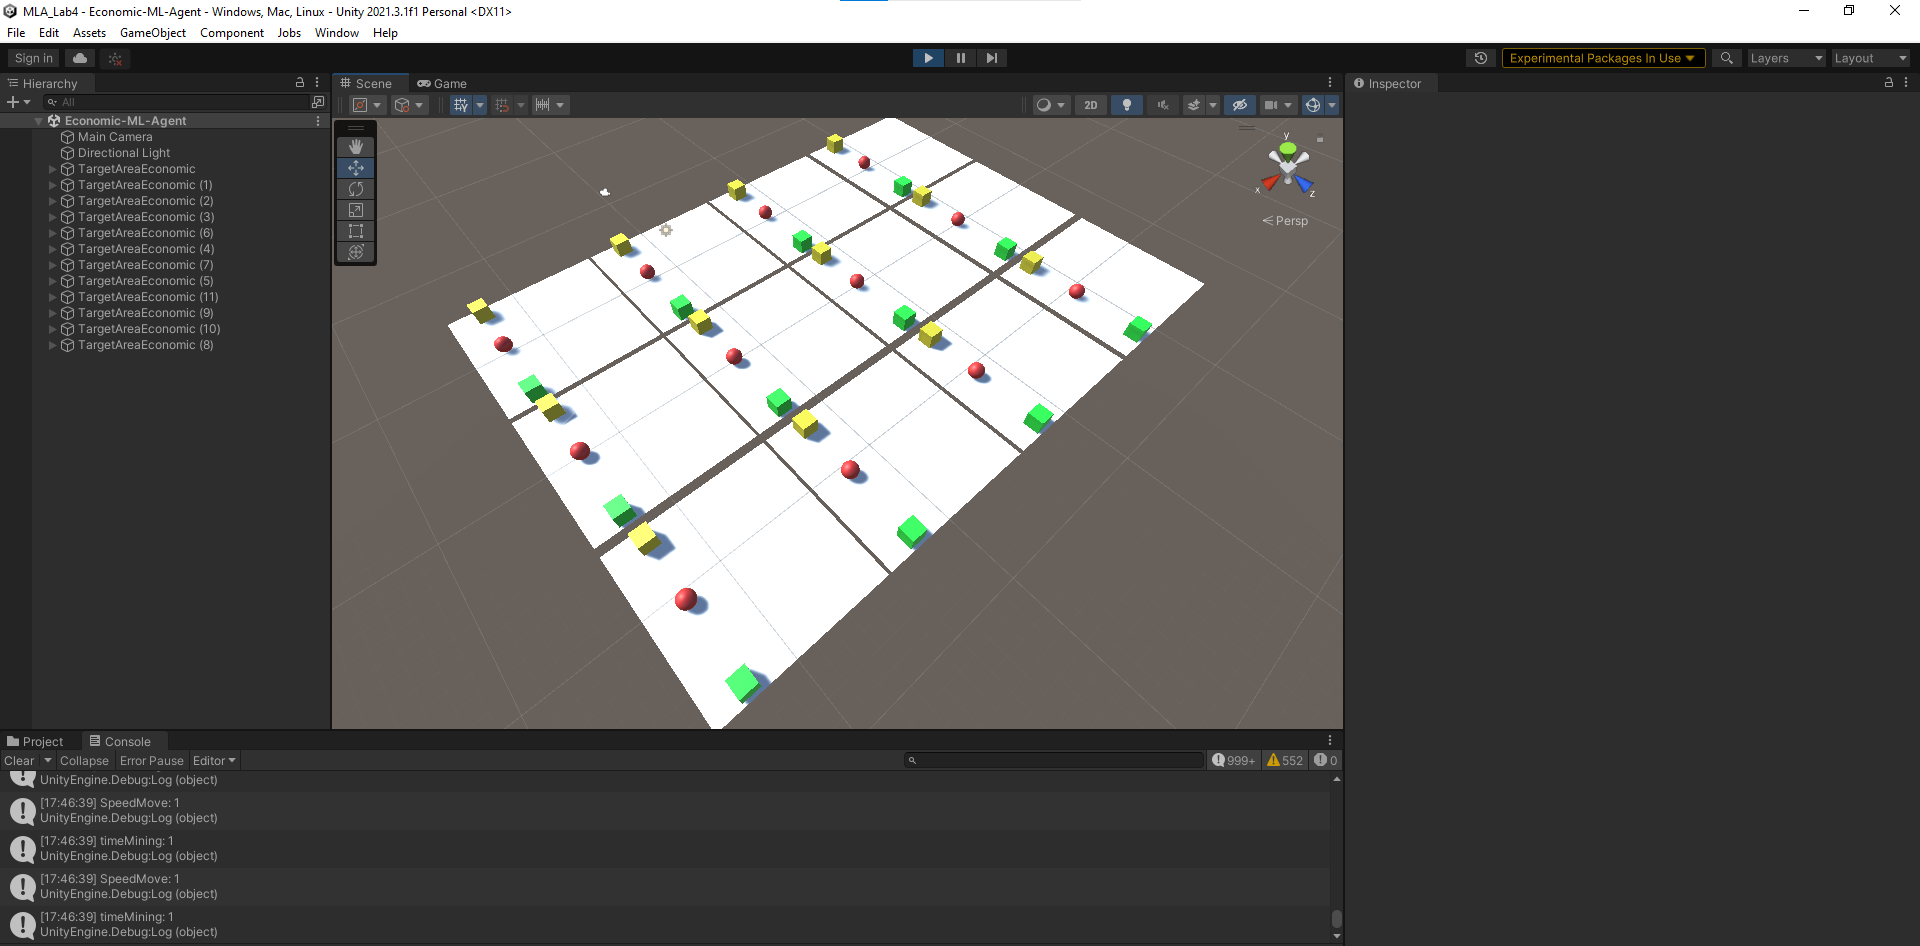
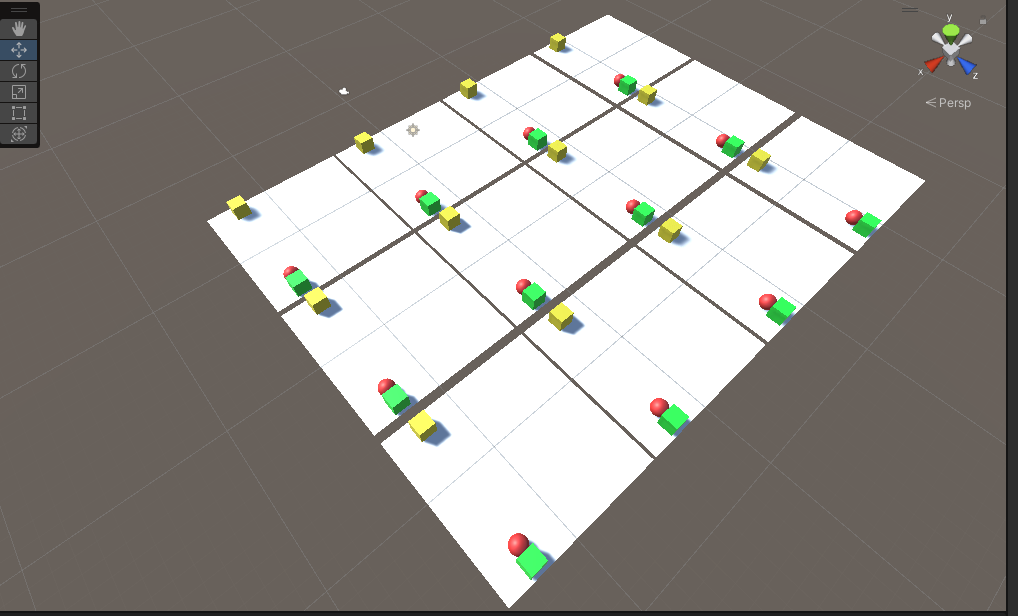
- 12 префабов TargetAreaEconomic
- процесс обучения модели
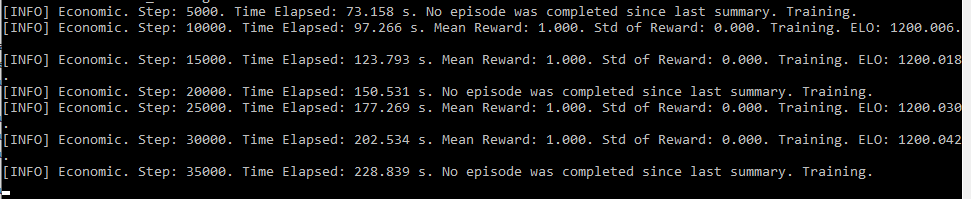
- Результаты
- TensorBoard графики
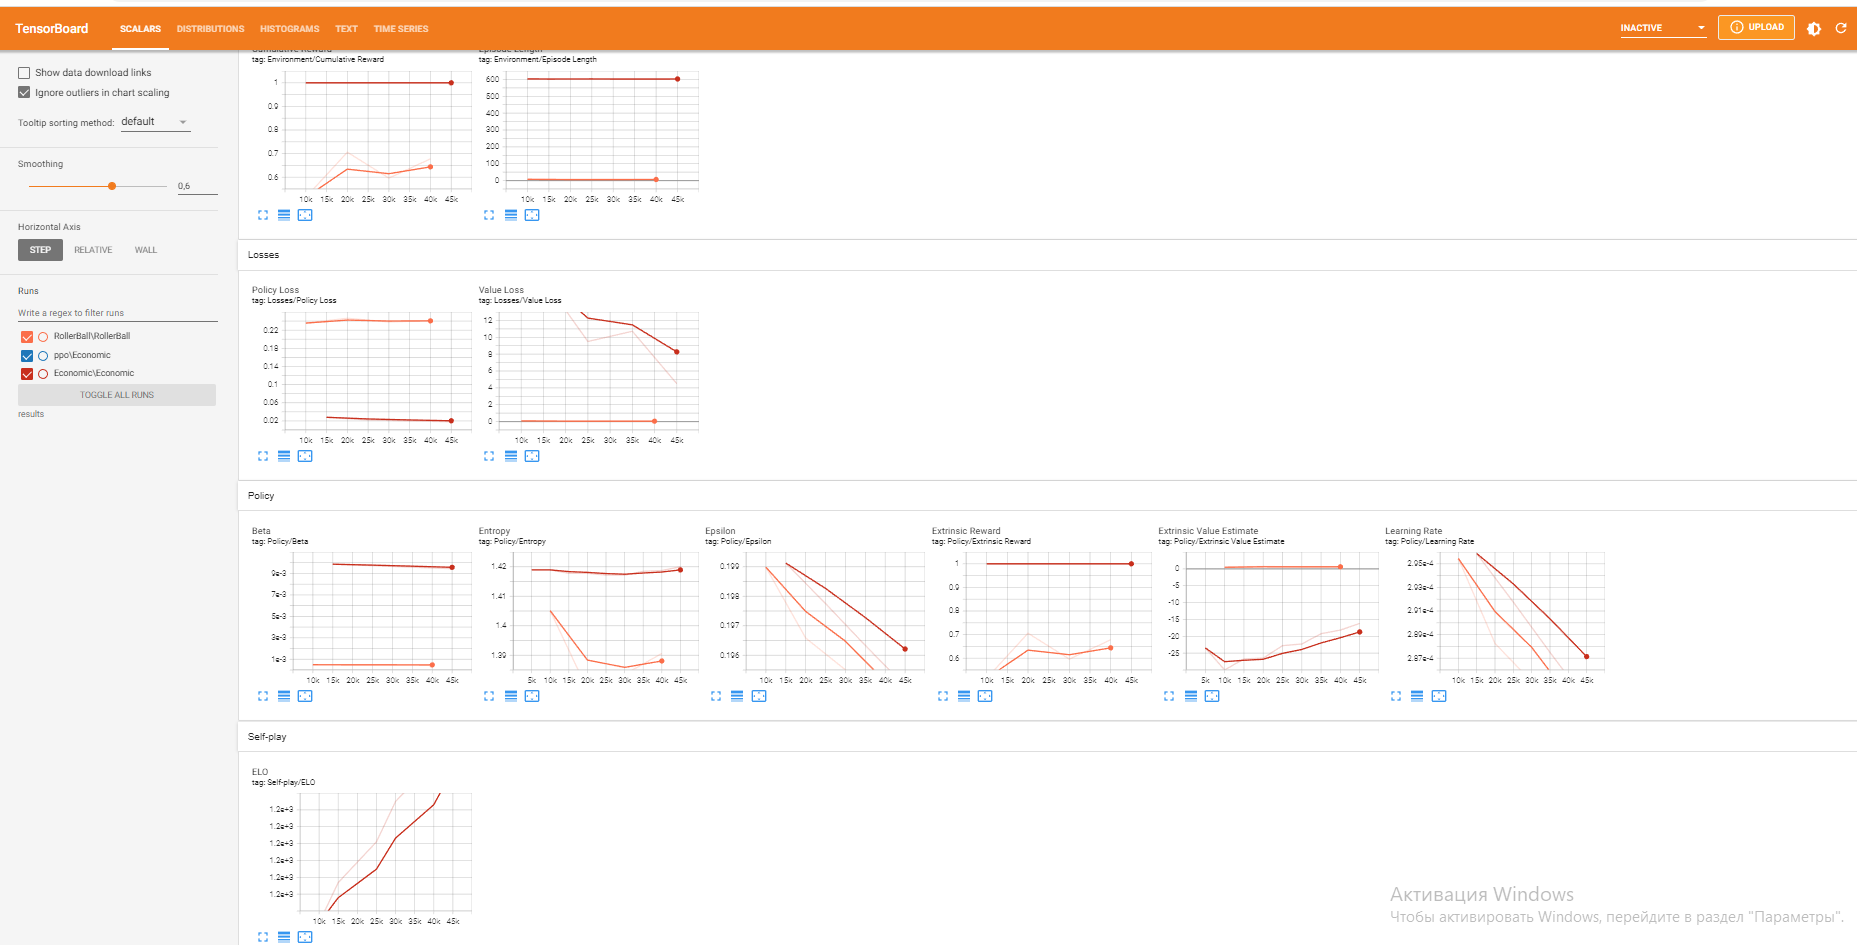
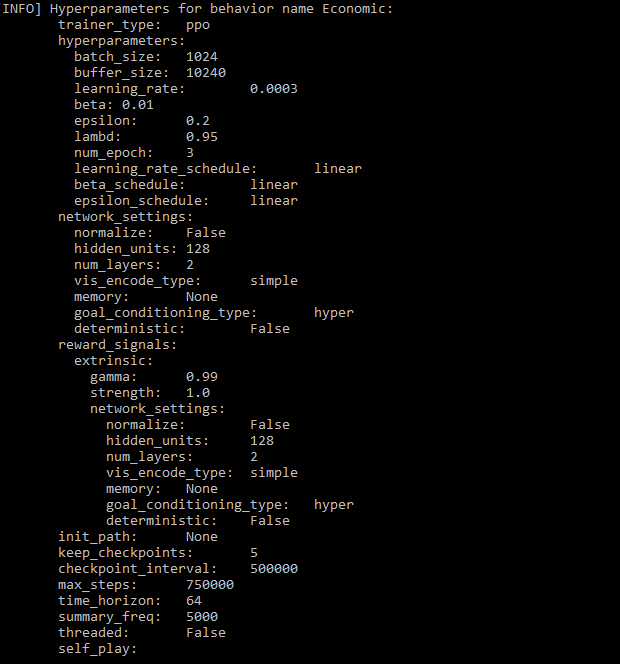
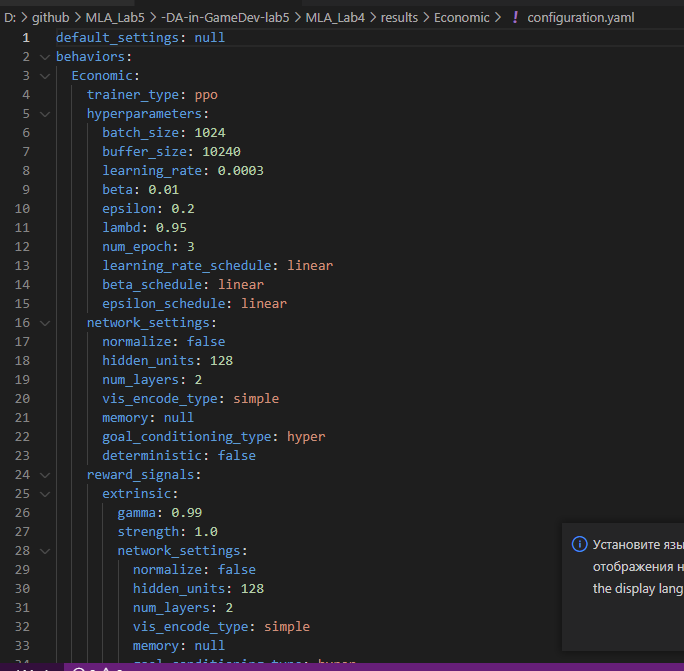
- Изменение параметров economic.yaml, изменил batch_size до 512(количество опытов на каждой итерации)
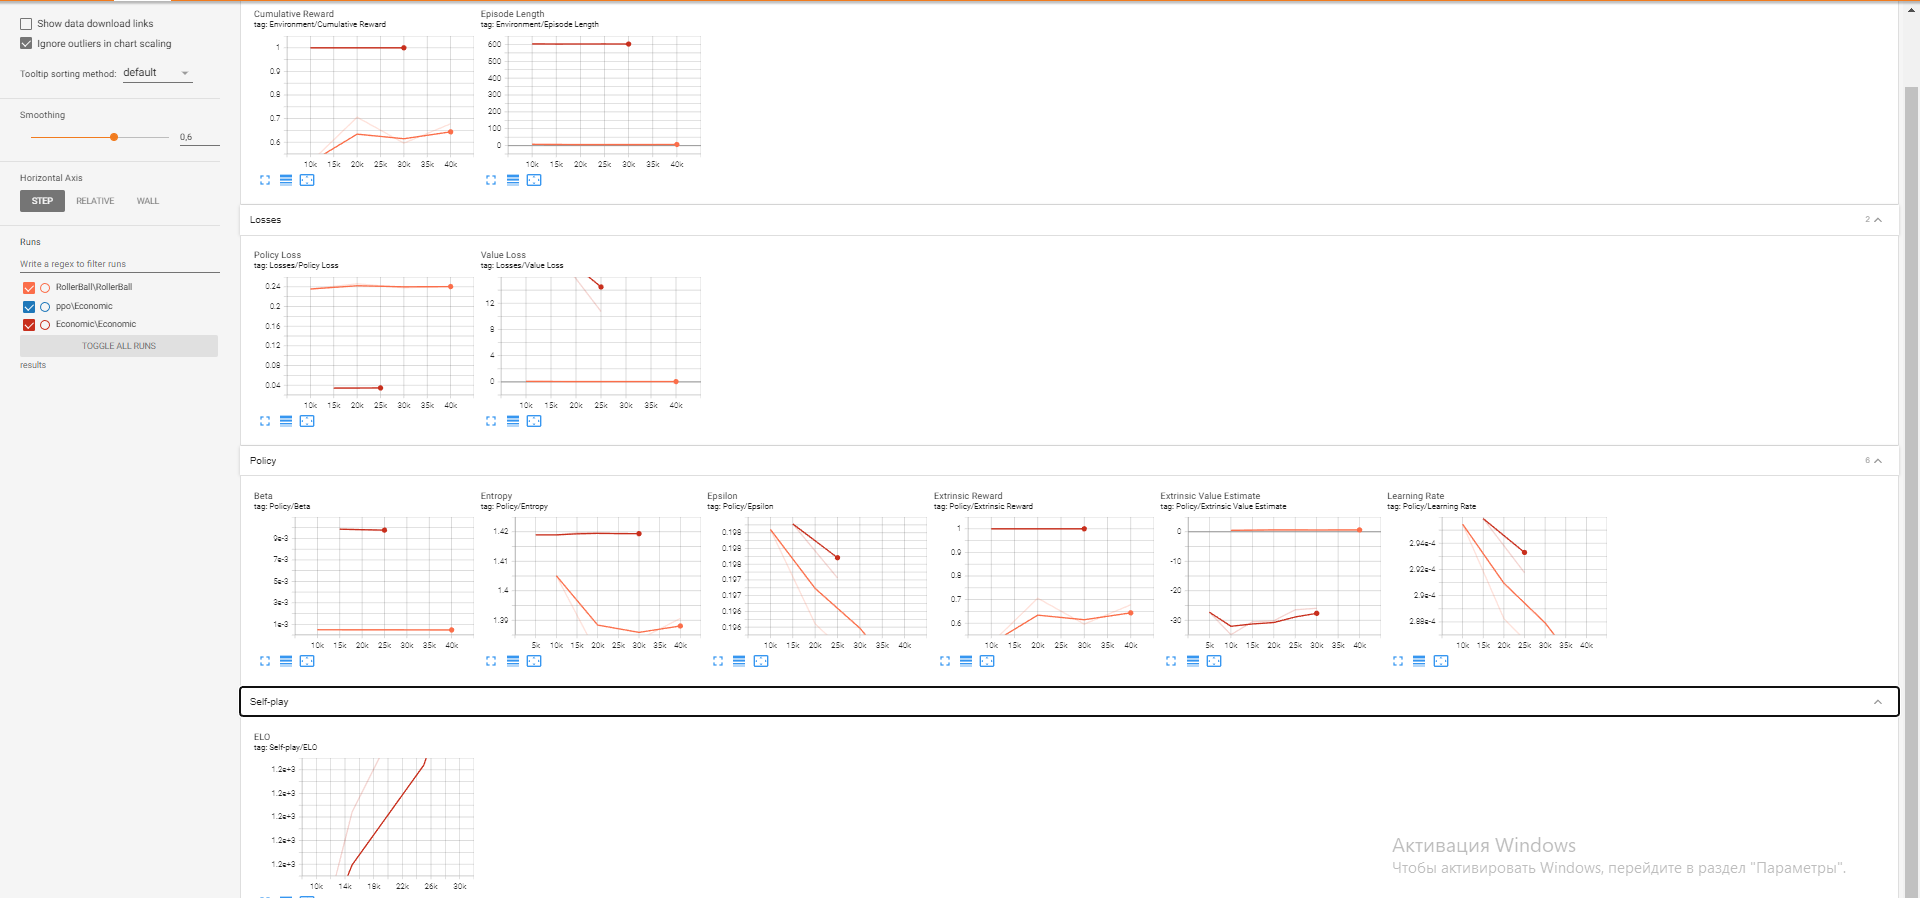
- изменил beta до 2.0e-2 (регулирует энтропию)
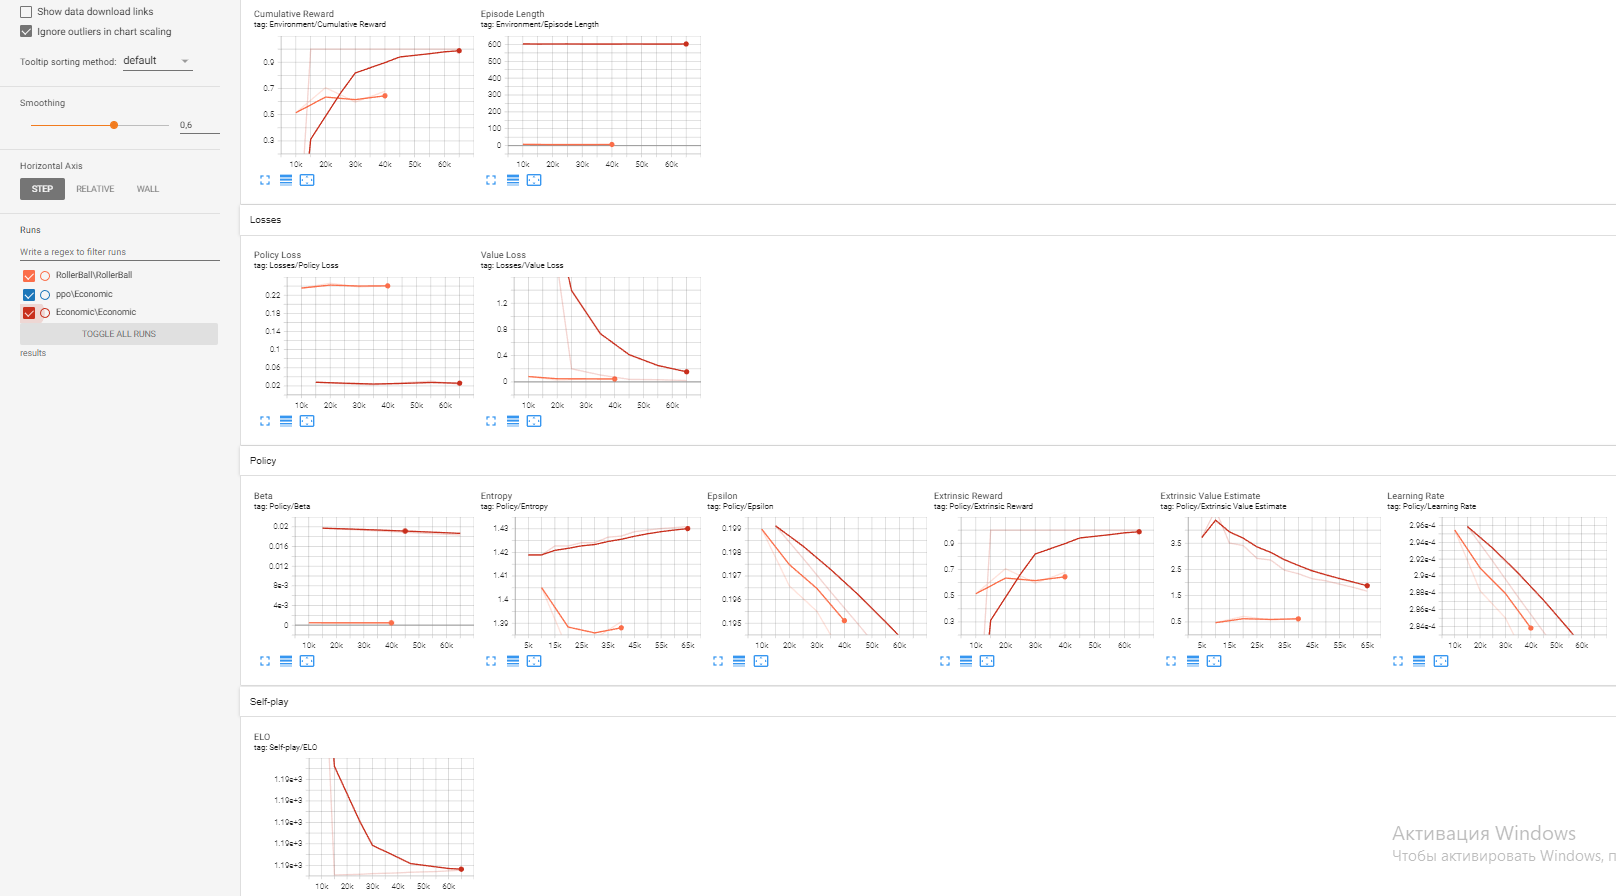
- рост общей награды и снижение потери значения
- изменил num_epoch до 6
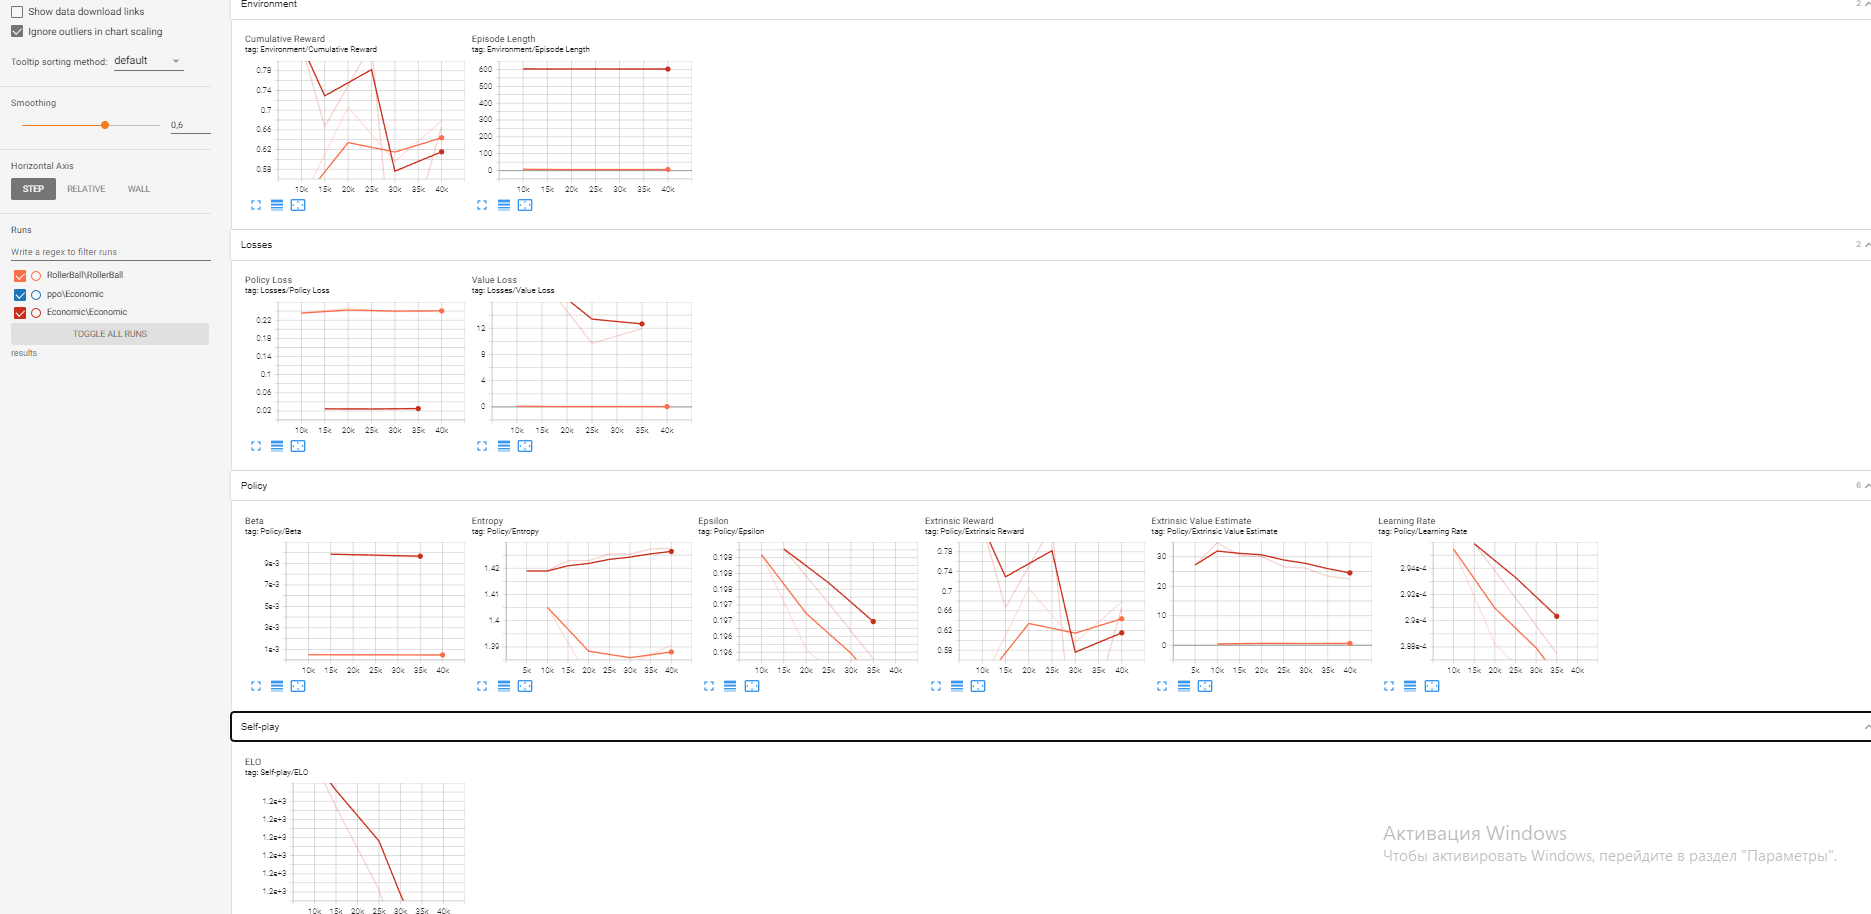
- скачкообразное снижение общей награды и потери значения
- изменил epsilon до 0.5(влияет на быстроту развития поведения)
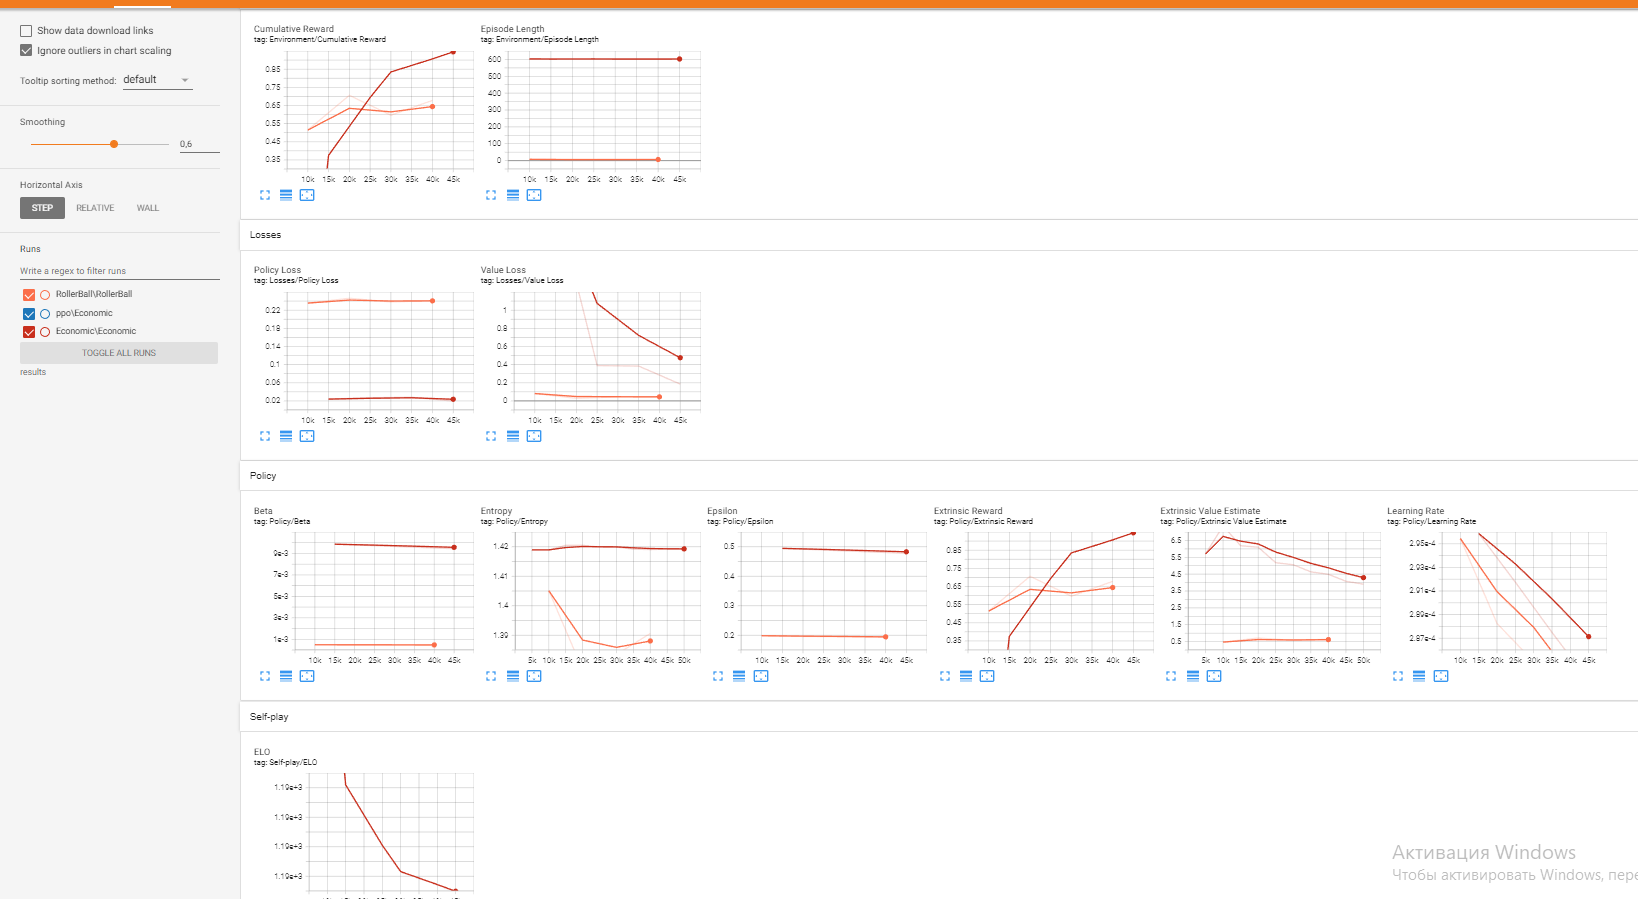
- немного ломаное повышение общей награды и снижение потери значения
- изменил learning_rate до 1.0e-4 (начальная скорость обучения)
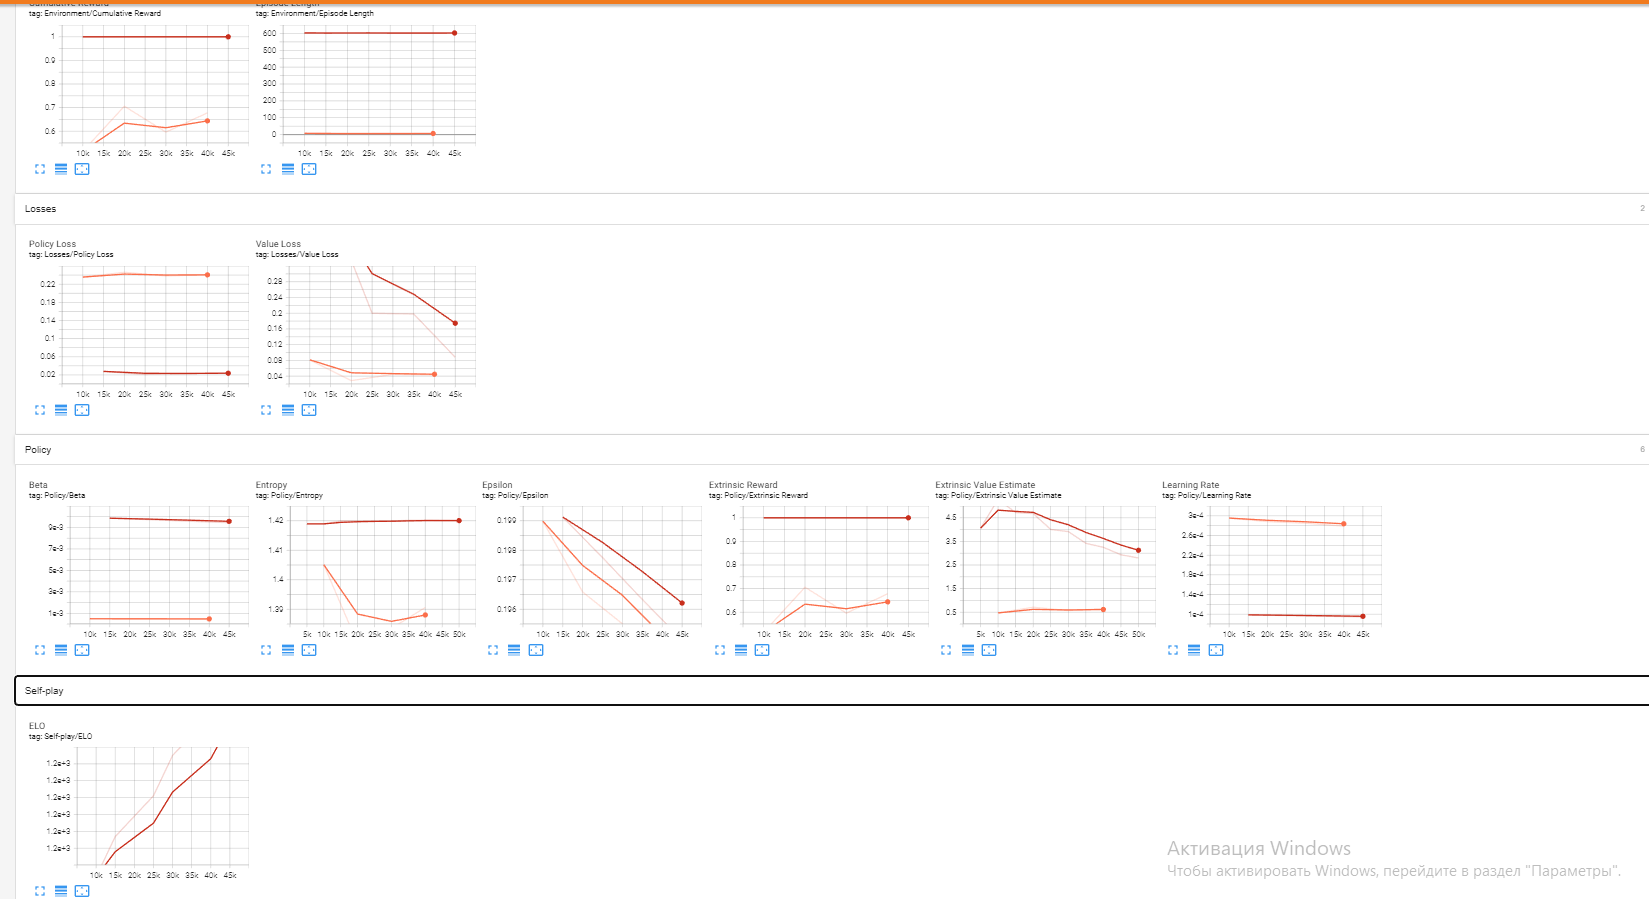
- общая награда равна 1, плавный спад потери значения
- Cumulative Reward - общая награда, должна постепенно увеличиваться до 1
- Episode Length - средняя продолжительность эпизода обучения
- Policy Loss - величина потери политики(процесс принятия решений), уменьшается во время успешного эпизода
- Value Loss - потеря значения, влияет на точность прогноза следующего состояния агентом, должна уменьшаться
- Entropy - насколько случайны решения модели, должен уменьшаться во время успешного эпизода
- Epsilon - влияет на быстроту развития поведения
- Learning Rate - начальная скорость обучения, должен уменьшаться линейно
- Beta - cила регуляризации энтропии, делает поведение более случайным, должен уменьшаться
-В ходе лабораторной работы я научился с помощью ML Agent внедрять и изменять экономические системы в проекте Unity, а также выводить графики с помощью TensorBoard и анализировать их.
BigDigital Team: Denisov | Fadeev | Panov